
Ein Geschäftsführer tippt in ChatGPT: „Ich suche Anbieter für Prüfstandstechnik im Bereich Antriebsstrang. Welche Unternehmen gehören auf meine Auswahlliste?” Er bekommt fünf Namen. Er ruft zwei davon an. Der dritte Anbieter, der fachlich am besten gepasst hätte, steht nicht auf der Liste – und erfährt nie, dass es diese Anfrage gab.
Die Frage, die dieser Artikel beantwortet, lautet: Woher nimmt das System die fünf Namen? Die Antwort ist unbequemer, als sie klingt. Sie stammen überwiegend nicht von den Herstellerseiten und auch nicht von den großen Bewertungsportalen, sondern aus Vergleichsartikeln und Ranglisten Dritter – oft von Seiten, die niemand im Unternehmen auf dem Schirm hat.
Abb. 1 · Kennzahl
Bei Kaufprompts zitiert die KI Listen – nicht Bewertungsportale, nicht Foren
Dieser Baustein gehört bei uns zur zweiten Visibility-Stufe – Stufe 2 · Empfohlen. Die erste Stufe sorgt dafür, dass ein KI-System Ihre Inhalte überhaupt lesen kann. Die zweite sorgt dafür, dass es Sie nennt, weil andere Sie nennen. Vergleichsartikel und Anbieter-Listen sind dort der Baustein mit der direktesten Verbindung zur Kaufentscheidung.
Was in der Untersuchung tatsächlich gemessen wurde
Die Overthink Group, eine amerikanische Content-Agentur, hat im Juni 2026 gemeinsam mit dem Messanbieter Amadora rund 1.260 Kaufprompts über vier Oberflächen laufen lassen: ChatGPT, Gemini, Perplexity und die Google AI Overviews. Veröffentlicht wurde das Ergebnis am 14. Juli 2026.
Der Aufbau ist wichtig für die Einordnung, deshalb hier die Kurzfassung: 250 nischige B2B-Softwarekategorien, ausgewählt über ein Suchvolumen zwischen 150 und 700 Anfragen pro Monat. Je Kategorie vier Promptvarianten, darunter die im Alltag realistische Formulierung „Ich recherchiere [Kategorie] für mein Team. Welche Anbieter gehören auf meine Auswahlliste?” Eine Woche Laufzeit.
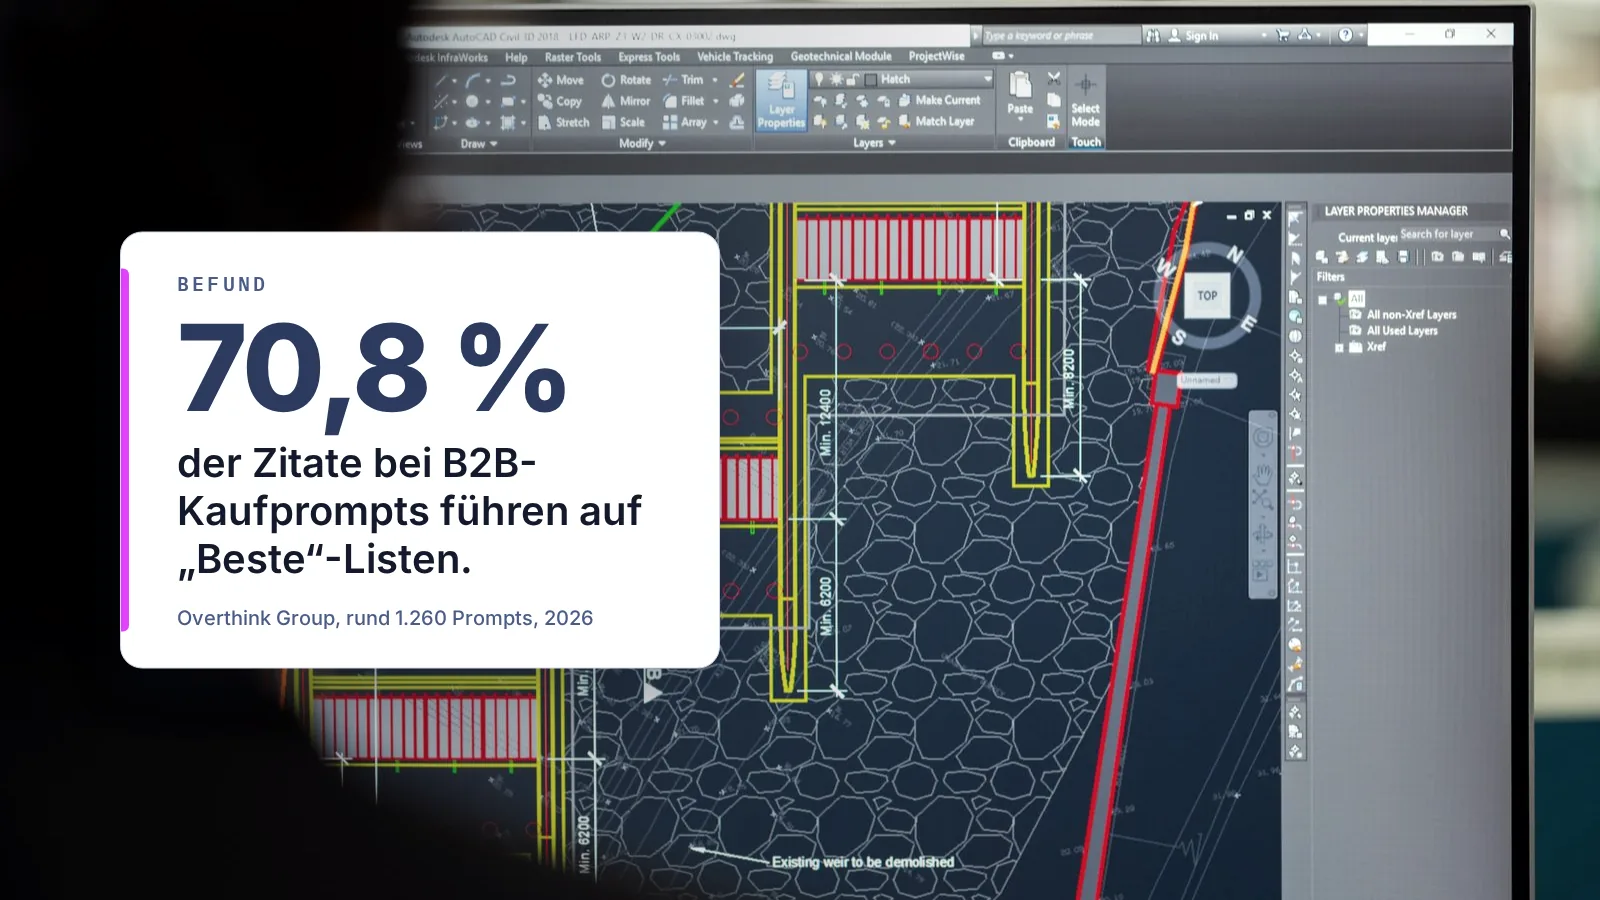
Der Kernbefund: 70,8 Prozent aller Zitate verwiesen auf Seiten, deren Title-Tag ein Superlativ trug – „best”, „top”, „leading” oder „popular”. Über die Hälfte der zitierten Seiten trug zusätzlich die Jahreszahl im Titel, 46,3 Prozent beides.
Hier ist Präzision nötig, weil die Zahl oft verkürzt zitiert wird: Gemessen wurde das Title-Tag der zitierten Seite, nicht ihr Inhalt und nicht ihre Qualität. Die Aussage lautet also nicht „KI empfiehlt die besten Anbieter”, sondern „KI zitiert überwiegend Seiten, die sich selbst als Bestenliste bezeichnen”. Das ist ein Unterschied, und er ist der eigentliche Befund.
Die Zahl, die die meisten überrascht
Die naheliegende Annahme wäre: Diese Listen stammen von Gartner, G2, Capterra – den Portalen, die B2B-Software seit Jahren bewerten. Der Autor der Studie schreibt, er habe genau das erwartet.
Gemessen hat er etwas anderes. Alle bekannten Bewertungsportale zusammen machten 8,6 Prozent der Zitate aus. Das G2-Netzwerk – G2 selbst, Capterra, GetApp und Software Advice – kam auf 8,0 Prozent, und davon stammten über 71 Prozent aus einer einzigen Oberfläche: Perplexity.
Die übrigen rund 62 Prozentpunkte der Listen-Zitate verteilen sich auf Fachmedien, Branchenblogs, Beratungsseiten – und auf eine Kategorie, über die man nicht hinwegsehen sollte.
Der Teil des Befunds, der niemandem gefällt
Die Untersuchung hat einen Anteil von 8,6 Prozent synthetischen Seiten zugeordnet: Sites, die programmatisch Tausende von Ranglisten erzeugen, mit erfundenen Autorenprofilen und ohne erkennbare Methodik. In ChatGPT machten sie 14,5 Prozent der Zitate aus, in Perplexity 11,3 Prozent. Die Google-Oberflächen zeigten das Problem praktisch nicht – AI Overviews 0,16 Prozent, Gemini 0,46 Prozent.
Wir halten das aus zwei Gründen fest. Erstens, weil es ehrlich ist: Ein erheblicher Teil dessen, was diese Systeme heute als Beleg heranziehen, hält keiner Prüfung stand. Zweitens, weil daraus keine Handlungsempfehlung folgt, die wir aussprechen würden. Auf solchen Seiten zu erscheinen, ist weder planbar noch wünschenswert, und der Zustand wird nicht bleiben. Wer seine Sichtbarkeit darauf baut, baut auf eine Lücke, die geschlossen wird.
Warum Listen und nicht Herstellerseiten
Der Mechanismus dahinter ist kein Geheimnis, sondern folgt aus der Aufgabe. Ein Sprachmodell, das eine Auswahlliste erstellen soll, braucht eine Quelle, die mehrere Anbieter nebeneinander nennt und gegeneinander einordnet. Eine Herstellerseite kann das strukturell nicht leisten – sie kennt genau ein Unternehmen und behauptet über dieses Unternehmen ausschließlich Gutes.
Eine Vergleichsseite liefert dagegen genau das Format, das die Frage verlangt: mehrere Namen, ein gemeinsamer Bewertungsrahmen, eine Reihenfolge. Sie ist der passendste Kandidat, bevor überhaupt jemand ihre Qualität geprüft hat.
Interessant wird es beim Vergleich der Oberflächen. Die Untersuchung hat für jede Plattform die 100 meistzitierten Domains daraufhin durchgesehen, ob dahinter ein Anbieter der jeweiligen Software steht. Das Ergebnis fiel deutlich aus: Bei den Google-Werkzeugen – AI Overviews und Gemini – waren rund drei Viertel dieser Top-Domains tatsächlich Anbieterseiten. Bei ChatGPT und Perplexity war es umgekehrt, dort waren rund drei Viertel keine Anbieterseiten.
Das hat eine praktische Konsequenz, die der Studienautor so formuliert: Man sollte „KI” nicht als einen Kanal behandeln. Wenn Ihre Zielgruppe überwiegend Google nutzt, zahlt die Arbeit an den eigenen Seiten stärker ein. Wenn sie mit ChatGPT oder Perplexity recherchiert, entscheidet, was andere über Sie schreiben.
Was ein Unternehmen daraus praktisch macht
Aus dem Befund folgen vier Schritte. Keiner davon ist ein Trick, und keiner wirkt in einer Woche.
1. Herausfinden, welche Listen in Ihrer Kategorie zitiert werden
Das ist kein Schätzwert, das ist eine Messung. Stellen Sie die Fragen, die Ihre Einkäufer stellen würden, in ChatGPT und in der Google KI-Übersicht, und notieren Sie, welche Quellen genannt werden. Nicht zwei Fragen, sondern acht bis zehn – die Streuung zwischen einzelnen Formulierungen ist erheblich.
Wichtig ist die Wortwahl: Nicht „Was ist die beste Prüfstandstechnik?”, sondern die Formulierung, die ein Einkäufer wirklich verwendet, mit Branche, Anwendungsfall und Rahmenbedingungen. Genau solche Fragen sind es, die in Suchkonsolen inzwischen als vollständige Absätze auftauchen.
Das Ergebnis ist eine Liste von zehn bis dreißig Quellen. Diese Liste ist Ihre Arbeitsgrundlage – nicht eine allgemeine Vorstellung davon, welche Portale „wichtig” sind.
2. Die Lücke zwischen dieser Liste und Ihrer Präsenz schließen
Jetzt wird der Abgleich konkret: Auf welchen dieser Seiten kommen Sie vor? Wo steht ein Wettbewerber und Sie nicht? Wo ist Ihr Eintrag vorhanden, aber falsch – veraltete Produktbezeichnung, falsche Kategorie, überholte Positionierung?
Der häufigste Befund in unserer Arbeit ist nicht das Fehlen, sondern die Unschärfe. Ein Unternehmen ist gelistet, aber unter einer Kategorie, in der niemand sucht, oder mit einer Beschreibung, aus der nicht hervorgeht, was es eigentlich anbietet. Für ein Sprachmodell ist ein unscharfer Eintrag fast so gut wie keiner.
3. Redaktionen liefern, was sie brauchen
Ein Platz in einem redaktionellen Vergleich ist kein Werbeplatz und lässt sich nicht kaufen – jedenfalls nicht dort, wo er etwas wert ist. Was ihn wahrscheinlicher macht, ist banal und wird trotzdem selten getan: nachprüfbare Angaben in der Form, in der eine Redaktion sie verarbeiten kann. Leistungsdaten statt Adjektiven. Eine klare Kategoriezuordnung. Ansprechbare Fachleute statt eines allgemeinen Postfachs.
Unsere Lieferentscheidung dazu ist bewusst eng: Wir schreiben Vergleichsartikel, aber wir trennen sie sichtbar. Ein Vergleich, in dem der Auftraggeber gewinnt, ist kein Vergleich – er ist eine Anzeige, und er wird als solche gelesen. Was dabei beschädigt wird, ist genau das Vertrauen, um das es in diesem Baustein geht.
4. Die eigene Vergleichsseite ernst nehmen
Der Teil, den Sie vollständig kontrollieren, ist Ihre eigene Seite. Sie taucht in den Zitaten der Google-Oberflächen häufig auf, und sie ist der einzige Ort, an dem Sie über Formulierung, Struktur und Aktualität selbst entscheiden.
Eine belastbare eigene Vergleichsseite nennt die Kriterien, bevor sie Namen nennt. Sie benennt Anwendungsfälle, in denen ein anderer Anbieter besser passt. Und sie trägt ein Datum, das stimmt – die Jahreszahl im Titel von über der Hälfte der zitierten Seiten ist kein Zufall, sondern ein Aktualitätssignal, auf das diese Systeme reagieren.
Wie eine Vergleichsseite aussieht, die zitiert werden kann
Wenn 70,8 Prozent der Zitate auf Listen entfallen und Sie eine eigene Liste veröffentlichen wollen, stellt sich die Frage, was eine verwertbare von einer belanglosen unterscheidet. Aus der Struktur der Messung und aus der Arbeitsweise dieser Systeme lassen sich fünf Eigenschaften ableiten.
Die Kriterien stehen vor den Namen. Eine Liste, die mit Platz 1 beginnt, behauptet eine Rangfolge, ohne ihren Maßstab offenzulegen. Eine Liste, die zuerst sagt, wonach sie bewertet – Durchsatz, Toleranzen, Schnittstellen, Lieferzeit –, liefert einem Sprachmodell den Zusammenhang, in dem die Namen stehen. Genau diese Zusammenhänge sind es, aus denen ein Modell seine Aussagen über Anbieter bildet.
Jeder Eintrag beantwortet dieselben Fragen. Uneinheitliche Einträge sind für einen Leser verzeihlich und für eine maschinelle Auswertung ein Problem. Wenn bei Anbieter A die Fertigungstiefe steht und bei Anbieter B die Gründungsgeschichte, lässt sich nichts vergleichen. Eine feste Struktur je Eintrag – wofür geeignet, wofür nicht, welche Einschränkung – ist der größte Hebel und der am seltensten genutzte.
Es gibt einen Fall, in dem jemand anders gewinnt. Das ist keine Höflichkeit, sondern der Unterschied zwischen einem Vergleich und einer Anzeige. Eine Liste ohne Gegenbeispiel ist als Eigenwerbung erkennbar – für den Leser in Sekunden, und zunehmend auch für die Systeme, die Belege gewichten.
Das Datum stimmt und ist sichtbar. Über die Hälfte der zitierten Seiten trägt die Jahreszahl im Titel. Das ist kein Trick mit der Überschrift: Diese Systeme bevorzugen belegbar aktuelle Inhalte, und eine Liste ohne erkennbares Bearbeitungsdatum ist im Zweifel eine von 2019. Eine Jahreszahl im Titel, hinter der keine Aktualisierung steht, ist allerdings das Gegenteil einer Lösung.
Die Seite steht für sich. Ein Abschnitt, der nur zusammen mit dem Rest der Seite Sinn ergibt, verliert seine Aussage, sobald er einzeln herausgelöst wird – und genau das passiert. Diese Systeme arbeiten nicht mit Seiten, sondern mit Passagen. Was der Absatz behauptet, muss im Absatz stehen.
Warum wir eigene Listen trotzdem nicht als Erstmaßnahme empfehlen
Eine eigene Vergleichsseite ist der Teil, den Sie kontrollieren – und genau deshalb der schwächere Beleg. Ein Sprachmodell, das prüft, welche Anbieter in einer Kategorie in Frage kommen, findet auf Ihrer Seite eine Selbstauskunft. Findet es dieselbe Aussage zusätzlich in zwei Fachmedien, hat es eine Bestätigung.
Die Reihenfolge ist deshalb: erst wissen, welche fremden Listen zitiert werden und ob Sie darin vorkommen. Dann die eigene Seite. Wer umgekehrt beginnt, hat eine gut gemachte Seite und weiß immer noch nicht, warum er in den Antworten fehlt.
Abb. 2 · Prüfliste
Fünf Eigenschaften einer Vergleichsseite, die zitiert werden kann
- Die Kriterien stehen vor den NamenPflichtErst der Maßstab, dann die Rangfolge.
- Jeder Eintrag beantwortet dieselben FragenPflichtEinheitliche Angaben lassen sich maschinell vergleichen.
- Es gibt einen Fall, in dem jemand anders gewinntPflichtDer Unterschied zwischen einem Vergleich und einer Anzeige.
- Das Datum stimmt und ist sichtbarPflicht51,6 % der zitierten Seiten tragen die Jahreszahl im Titel.
- Jeder Abschnitt steht für sichPflichtDie KI zitiert Passagen, nicht Seiten.
Was dieser Befund nicht bedeutet
Drei Einschränkungen gehören dazu, und wir nennen sie lieber selbst.
Die Studie ist nicht der deutsche Mittelstand. Sie deckt nischige B2B-Softwarekategorien im US-Markt ab. Der Autor schreibt ausdrücklich, dass sich alle Zahlen auf sein Experiment beziehen. Von 1.000 geprüften Keywords lösten überhaupt nur 264 eine AI Overview aus. Die Richtung ist belastbar, die genauen Anteile sind es für Ihre Kategorie nicht.
Der Absender hat ein Interesse. Die Overthink Group verkauft Content-Strategie und schreibt unter anderem Listicles. Das entwertet die Messung nicht – die Methodik ist offengelegt und nachvollziehbar –, aber es gehört dazugesagt.
Der Zustand ist eine Momentaufnahme. Dass ChatGPT derzeit in 14,5 Prozent der Fälle synthetische Seiten zitiert, ist ein Fehler im System und kein Naturgesetz. Der Studienautor rechnet selbst damit, dass sich das ändert. Eine Strategie, die auf der heutigen Schwäche eines Systems beruht, ist keine.
Was bleibt, ist der strukturelle Teil: Kaufentscheidungen werden zunehmend über Quellen vorbereitet, die nicht Ihnen gehören. Das war vor der KI-Suche schon so, und es ist messbarer geworden.
Wie das mit den übrigen Bausteinen zusammenhängt
Vergleichsartikel stehen nicht allein. Sie sind der zweite von fünf Bausteinen der Stufe 2 · Empfohlen, und sie wirken erst, wenn die erste Stufe steht: Wenn ein KI-System Ihre Seiten technisch nicht lesen kann, hilft es wenig, in einer fremden Liste zu stehen – dann fehlt die Bestätigung, die das System sucht, wenn es Ihren Namen prüft. Den Gesamtzusammenhang – vom Modellwissen über die Websuche bis zur Auswahl der Namen – beschreibt der Artikel In ChatGPT als Anbieter empfohlen werden.
Eng verwandt ist der Baustein davor, die Markennennungen auf Drittseiten. Beide beschreiben dasselbe Grundprinzip aus zwei Richtungen: Ihre Sichtbarkeit in KI-Antworten entsteht überwiegend außerhalb Ihrer eigenen Website. Der Unterschied liegt im Anlass – eine Markennennung kann in jedem Zusammenhang stehen, ein Vergleichsartikel steht genau dort, wo jemand kurz vor einer Entscheidung steht.
Wer die Begriffe dahinter nachschlagen möchte: Das GEO-Glossar erklärt unter anderem Grounding und Query Fan-out – die beiden Mechanismen, die erklären, warum eine einzelne Einkäuferfrage intern in mehrere Teilfragen zerfällt und an mehreren Stellen nach Belegen sucht.
Der ehrliche Schluss
Es gibt keine Garantie, auf einer Liste zu erscheinen, und wir geben keine. Was sich planen lässt, ist die Vorarbeit: wissen, welche Listen in Ihrer Kategorie tatsächlich zitiert werden, die Einträge korrigieren, die falsch sind, und den Redaktionen liefern, was sie brauchen.
Was sich messen lässt, ist der Ausgangspunkt. Wenn Sie wissen möchten, welche Quellen ChatGPT und die Google KI-Übersicht bei den Fragen Ihrer Einkäufer heranziehen – und ob Ihr Unternehmen darin vorkommt –, ist das genau das, was das Digital Visibility Audit misst.
Weitere Begriffe im Glossar: Listicles. Neben Listen ist YouTube eine Quelle, die Unternehmen selbst füllen können; wie sich die Wirkung messen lässt, zeigt die Auswertung von 7.184 KI-Antworten.